למה העברית יוצאת הפוכה ב-PDF, ומה עושים
מאת Baseline Paper · · 4 דק׳ קריאה
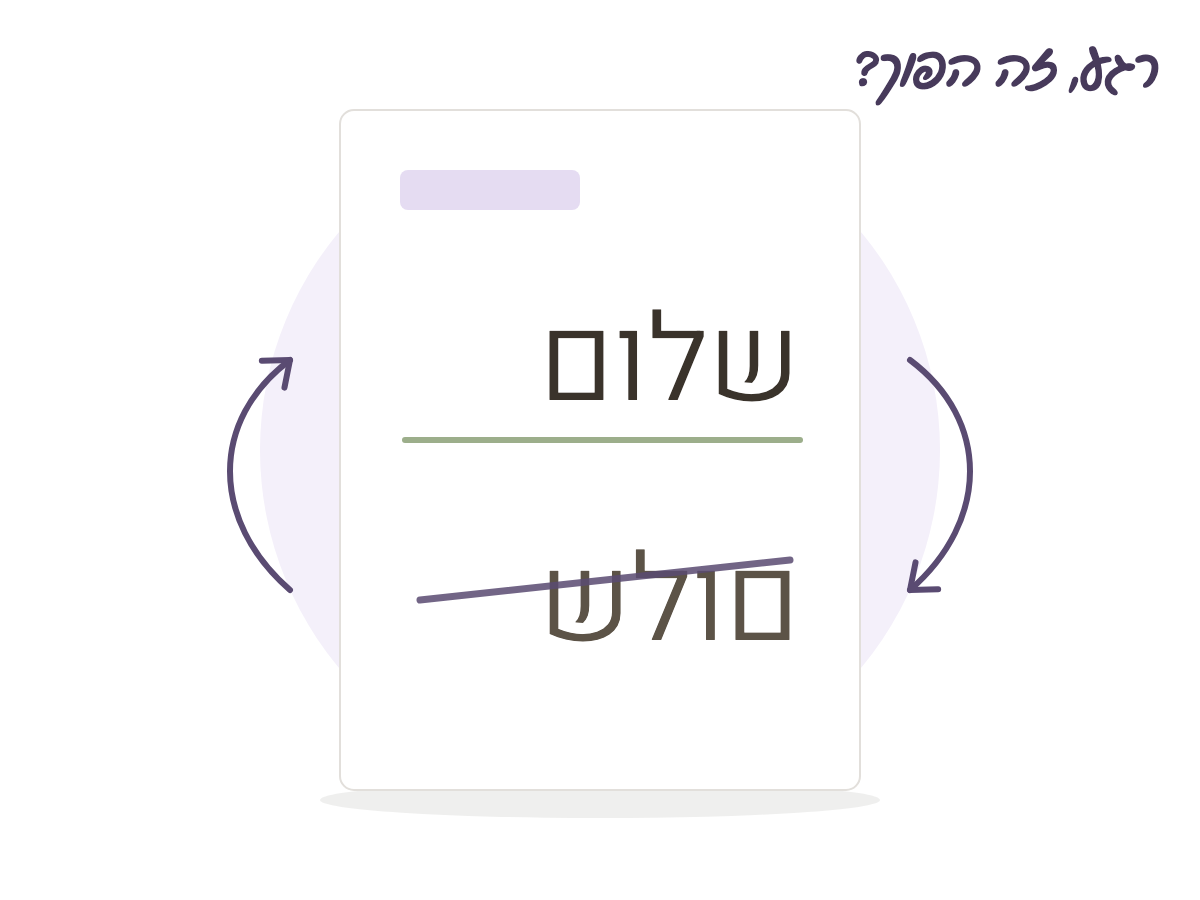
מכירים את זה. פותחים סיכום ב-PDF, טופס ממשלתי, או תבנית שהורדתם מהאינטרנט, ופתאום רואים עברית הפוכה ב-PDF. לא כתובת מוזרה, ממש הפוכה: מילים בסדר ההפוך, לפעמים אפילו אותיות בתוך מילה מתחלפות ביניהן.
זה קורה יותר ממה שחושבים, וזה כמעט תמיד לא הטלפון או האייפד שלכם. זה הקובץ. יכול לקרות בסילבוס מהמזכירות, במסמך שמרצה שלח בלילה לפני המבחן, או בטופס שנועד להיות ממולא ולא רק להיקרא.
בואו נבין למה זה קורה ומה בכלל עושים כשזה קורה לכם, בין אם אתם רק קוראים או צריכים גם להעתיק ולחפש בתוך הטקסט.
למה בכלל יוצא עברית הפוכה ב-PDF
בקובץ PDF כל אות מקבלת מיקום מדויק על הדף. הקובץ בעצמו לא “יודע” שעברית נקראת מימין לשמאל, אלא אם התוכנה שיצרה אותו סידרה את האותיות לפי כיוון הקריאה הנכון. יש שם אלגוריתם שאמור לעשות בדיוק את זה, והוא ממיר בין הסדר שבו הקלידו לבין הסדר שבו זה אמור להיראות על המסך.
הבעיה: הרבה תוכנות נבנו קודם לאנגלית ורק אחר כך “טולאו” לעברית. אם השלב הזה לא בוצע כמו שצריך, האותיות נשמרות בקובץ בסדר הפוך לזה שהעין קוראת. התוצאה היא בדיוק עברית הפוכה ב-PDF, אפילו כשמי שיצר את הקובץ בכלל לא שם לב, כי אצלו במחשב, בתוכנה שבה כתב, זה נראה תקין.
הבעיה בעין או הבעיה בקובץ
חשוב להפריד בין שתי תקלות שנראות אותו דבר. לפעמים הדף עצמו נראה הפוך על המסך, וזה בדרך כלל סריקה או ייצוא גרוע, וגם אז זה נדיר יחסית. אבל הרבה יותר נפוץ שהדף נראה תקין לגמרי, ורק שכבת הטקסט שמתחת אליו שמורה בסדר הפוך. העין לא שמה לב לזה, אבל ברגע שמנסים להעתיק שורה, לחפש מילה או להעביר את הטקסט למקום אחר, הבעיה קופצת החוצה. זו הסיבה שאותו קובץ יכול להיראות מושלם לקריאה ועדיין לגרום כאב ראש כשמנסים לעבוד איתו.
איך בודקים תוך עשר שניות
הבדיקה הכי מהירה: מסמנים שורה של עברית בתוך הקובץ ומעתיקים אותה להערות או לוואטסאפ. אם היא יוצאת מסודרת אחורה, מילה אחרי מילה בכיוון הלא נכון, זה אומר ששכבת הטקסט היא הבעיה, לא העיניים שלכם. אם ההעתקה יוצאת תקינה, כנראה שהקובץ בסדר וזה היה עניין אחר, למשל גופן חסר.
מה עושים כשרק כותבים על הקובץ
אם אתם רק פותחים את ה-PDF כדי לכתוב עליו ביד, ב-Goodnotes, ב-Notability או ב-Noteshelf, ורואים אותו נכון על המסך, אין סיבה לדאגה. הכתיבה שלכם עם העט היא שכבה נפרדת לגמרי, שמונחת מעל הדף, ולא נוגעת בשכבת הטקסט הבעייתית שמתחת. אתם פשוט כותבים כרגיל, גם אם הטקסט המקורי שמתחת סובל מהבעיה הזו.
מה עושים כשצריך את הטקסט עצמו
כשצריך באמת להעתיק משפט, לחפש מילה בתוך הקובץ, או שמשהו קורא את הדף בקול, שכבת הטקסט חשובה, ואי אפשר להתעלם ממנה. הפתרון הכי טוב הוא לחזור למקור: אם הקובץ יצא מוורד, מפייג’ז או מגוגל דוקס, מייצאים אותו מחדש משם, כי שם קורה השלב שבו הסדר אמור להסתדר נכון. לנסות “לתקן” את ה-PDF עצמו כמעט תמיד לא עובד, כי בשלב הזה אין יותר גישה למקור שממנו אפשר לייצא נכון מהתחלה.
כשאין גישה למקור בכלל, למשל קובץ שקיבלתם ולא כתבתם, אפשר פשוט להקליד מחדש רק את המשפט שצריך, במקום לסמוך על שכבה שכבר יודעים שהיא לא אמינה. חיפוש טקסט בתוך אפליקציית קריאה לא יעזור כאן, כי הוא מחפש באותה שכבה שבורה. חיפוש בכתב יד, לעומת זאת, שייך לעניין אחר לגמרי: הוא מזהה את מה שאתם כותבים ביד על העמוד, לא את הטקסט המודפס שמתחתיו.
מה זה אומר על תבנית בעברית
הבעיה הזו לא קורה כשמישהו בונה את החומר בעברית מהיסוד, ולא מתרגם או מתקן תבנית אנגלית בדיעבד. מחברת קורנל בעברית של Baseline Paper בנויה כך: עמודת מילות המפתח בצד ימין, בדיוק איפה שהעין מתחילה לקרוא, האינדקס המקושר ב-100 שורות וכפתורי הניווט בכל עמוד עובדים בכיוון של ספר עברי מהתחלה, לא בגלל תיקון אחרי. ככה אין רגע שבו הסדר “יוצא הפוך”, כי הוא היה נכון כבר בטיוטה הראשונה.